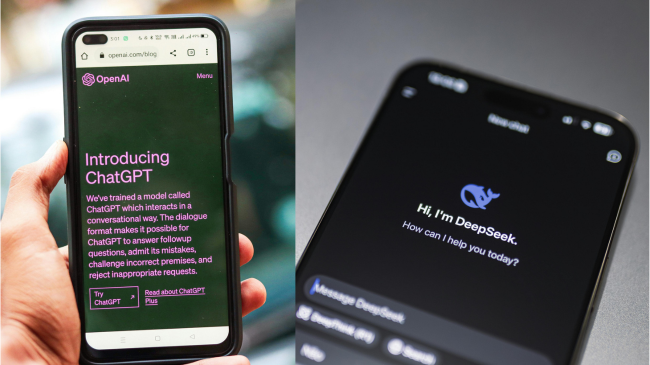
Deri pak javë më parë, pak njerëz në botën perëndimore kishin dëgjuar për një kompani të vogël kineze të Inteligjencës Artificiale (AI) të njohur si DeepSeek. Por më 20 janar, ajo tërhoqi vëmendjen globale kur publikoi një model të ri të AI të quajtur R1.
R1 është një model "arsyetimi", që do të thotë se funksionon përmes detyrave hap pas hapi dhe detajon procesin e tij të punës tek një përdorues. Është një version më i avancuar i modelit V3 të DeepSeek, i cili u publikua në dhjetor. Oferta e re e DeepSeek është pothuajse po aq e fuqishme sa modeli më i avancuar i AI o1 i kompanisë rivale OpenAI, por me një pjesë të kostos.
Brenda pak ditësh, aplikacioni i DeepSeek tejkaloi ChatGPT në shkarkime të reja dhe uli çmimet e aksioneve të kompanive të teknologjisë në Shtetet e Bashkuara. Ai gjithashtu bëri që OpenAI të pretendonte se rivali i tij kinez kishte grabitur në mënyrë efektive disa nga bizhuteritë e kurorës nga modelet e OpenAI për të ndërtuar të tijat.
Në një deklaratë për New York Times, kompania tha: “Ne jemi të vetëdijshëm dhe po shqyrtojmë indikacionet që DeepSeek mund të ketë distiluar në mënyrë të papërshtatshme modelet tona dhe do të ndajmë informacione siç dimë më shumë. Ne marrim kundërmasa agresive, proaktive për të mbrojtur teknologjinë tonë dhe do të vazhdojmë të punojmë ngushtë me qeverinë amerikane për të mbrojtur modelet më të afta që po ndërtohen këtu.”
The Conversation iu afrua DeepSeek për koment, por ajo nuk u përgjigj.
Por edhe nëse DeepSeek ka kopjuar - ose, në gjuhën shkencore, "distiluar", të paktën disa nga ChatGPT për të ndërtuar R1, ia vlen të kujtojmë se OpenAI gjithashtu akuzohet për mosrespektim të pronës intelektuale gjatë zhvillimit të modeleve të tij.
Çfarë është distilimi?
Distilimi i modelit është një teknikë e zakonshme e mësimit të makinerive në të cilën një "model studenti" më i vogël trajnohet mbi parashikimet e një "modeli mësuesi" më të madh dhe më kompleks.
Kur të përfundojë, studenti mund të jetë pothuajse po aq i mirë sa mësuesi, por do të përfaqësojë njohuritë e mësuesit në mënyrë më efektive dhe kompakte.
Për ta bërë këtë, nuk është e nevojshme të qaseni në punën e brendshme të mësuesit. Gjithçka që duhet për të arritur këtë truk është t'i bëjmë modelit të mësuesit pyetje të mjaftueshme për të trajnuar studentin.
Kjo është ajo që OpenAI pretendon se DeepSeek ka bërë: pyeti o1 të OpenAI në një shkallë masive dhe përdori rezultatet e vëzhguara për të trajnuar modelet më efikase të DeepSeek.
Një pjesë e burimeve
DeepSeek pretendon se trajnimi dhe përdorimi i R1 kërkonin vetëm një pjesë të burimeve të nevojshme për të zhvilluar modelet më të mira të konkurrentëve të tyre.
Ka arsye për të qenë skeptikë për disa nga reklamat e marketingut të kompanisë për shembull, një raport i ri i pavarur sugjeron se shpenzimi i harduerit për R1 ishte deri në 500 milionë dollarë. Por edhe kështu, DeepSeek u ndërtua ende shumë shpejt dhe me efikasitet krahasuar me modelet rivale.
Kjo mund të jetë për shkak se DeepSeek distiloi prodhimin e OpenAI. Megjithatë, aktualisht nuk ka asnjë metodë për ta vërtetuar këtë përfundimisht. Një metodë që është në fazat e hershme të zhvillimit është vendosja e ujit të rezultateve të AI. Kjo shton modele të padukshme në rezultatet, të ngjashme me ato të aplikuara për imazhet me të drejtë autori. Ka mënyra të ndryshme për ta bërë këtë në teori, por asnjëra nuk është aq efektive apo efikase sa ta ketë bërë atë në praktikë.
Ka arsye të tjera që ndihmojnë në shpjegimin e suksesit të DeepSeek, si puna teknike e thellë dhe sfiduese e kompanisë.
Përparimet teknike të bëra nga DeepSeek përfshinin përfitimin e çipave më pak të fuqishëm, por më të lirë të AI (të quajtura gjithashtu njësi përpunimi grafik ose GPU).
DeepSeek nuk kishte zgjidhje tjetër veçse të përshtatej pasi SHBA-ja i ka ndaluar firmat të eksportojnë çipat më të fuqishëm të AI në Kinë.
Ndërsa kompanitë perëndimore të AI mund të blejnë këto njësi të fuqishme, ndalimi i eksportit i detyroi kompanitë kineze të inovojnë për të përdorur sa më mirë alternativat më të lira.
Një sërë procesesh gjyqësore
Kushtet e përdorimit të OpenAI thonë në mënyrë të qartë se askush nuk mund të përdorë modelet e tij të AI për të zhvilluar produkte konkurruese. Sidoqoftë, modelet e veta janë trajnuar në grupe të dhënash masive të gërvishtura nga uebfaqja. Këto grupe të dhënash përmbanin një sasi të konsiderueshme të materialit me të drejtë autori, të cilin OpenAI thotë se ka të drejtë ta përdorë në bazë të "përdorimit të drejtë": “Trajnimi i modeleve të AI duke përdorur materiale të disponueshme publikisht në internet është përdorim i drejtë, siç mbështetet nga precedentë të gjatë dhe të pranuar gjerësisht. Ne e shohim këtë parim si të drejtë për krijuesit, të nevojshëm për novatorët dhe kritik për konkurrencën e SHBA-së.”
Ky argument do të testohet në gjykatë. Gazetat, muzikantët, autorët dhe krijuesit e tjerë kanë ngritur një sërë padish kundër OpenAI me arsyetimin e shkeljes së të drejtave të autorit.
Sigurisht, kjo është mjaft e dallueshme nga ajo që OpenAI akuzon DeepSeek për të bërë. Sidoqoftë, OpenAI nuk po tërheq shumë simpati për pretendimin e tij se DeepSeek korri në mënyrë të paligjshme produktin e modelit të tij.
Lufta e fjalëve dhe padive është një artefakt se si përparimi i shpejtë i AI ka tejkaluar zhvillimin e rregullave të qarta ligjore për industrinë. Dhe ndërsa këto ngjarje të fundit mund të zvogëlojnë fuqinë e drejtuesve të AI, shumë varet nga rezultati i mosmarrëveshjeve të ndryshme ligjore në vazhdim.
Duke tundur bisedën globale
DeepSeek ka treguar se është e mundur të zhvillohen modele më të fundit me çmim të lirë dhe efikas. Nëse ata mund të konkurrojnë me OpenAI në një fushë loje të barabartë, mbetet për t'u parë.
Gjatë fundjavës, OpenAI u përpoq të demonstronte epërsinë e saj duke lëshuar publikisht modelin e tij më të avancuar të konsumatorit, o3-mini.
OpenAI pretendon se ky model në mënyrë të konsiderueshme tejkalon edhe versionin e tij të mëparshëm kryesor në treg, o1, dhe është "modeli më me kosto efektive në serinë tonë të arsyetimit".
Këto zhvillime paralajmërojnë një epokë zgjedhjesh në rritje për konsumatorët, me një larmi modelesh të AI në treg. Ky është një lajm i mirë për përdoruesit: presionet konkurruese do t'i bëjnë modelet më të lira për t'u përdorur.
Dhe përfitimet zgjerohen më tej.
Trajnimi dhe përdorimi i këtyre modeleve vendos një tendosje masive në konsumin global të energjisë. Ndërsa këto modele bëhen më të përhapura, ne të gjithë përfitojmë nga përmirësimet në efikasitetin e tyre.
Rritja e DeepSeek sigurisht shënon një territor të ri për ndërtimin e modeleve më lirë dhe me efikasitet. Ndoshta do të shkundë gjithashtu bisedën globale se si kompanitë e AI duhet të mbledhin dhe përdorin të dhënat e tyre të trajnimit.
/Motilokal.com